Jev: la guía completa del modelo que decide en vez de escribir
Cada vez que le pides a un LLM un simple sí o no, estás pagando de más y esperando de más. Esto es lo que hay que saber para dejar de hacerlo.
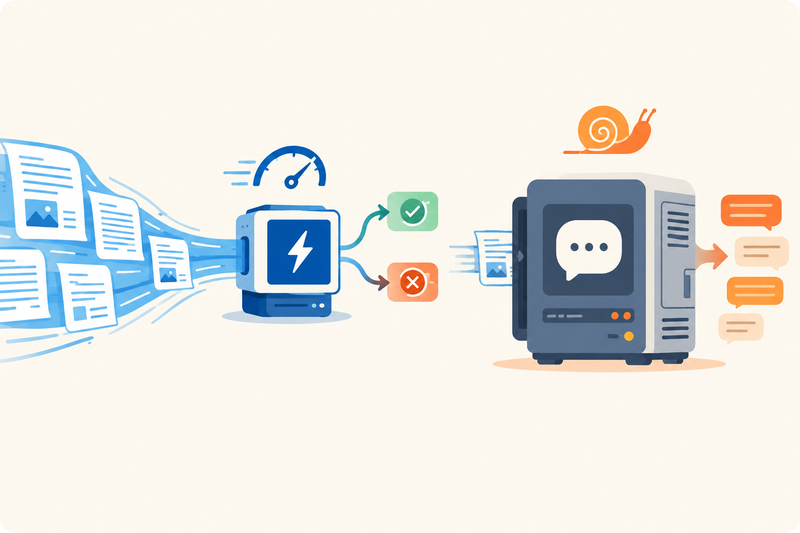

Tienes un flujo con IA que clasifica correos, o etiqueta comentarios, o decide si un lead vale la pena. Y usas el mismo modelo con el que escribes emails o generas código. Funciona, sí, pero es como pedirle a un catedrático que te diga si un número es par o impar: te va a dar la respuesta correcta, tardando más de la cuenta y cobrándote como si te estuviera escribiendo un ensayo.
La mayoría de las decisiones que tomamos con IA no necesitan redacción. Necesitan una elección entre opciones cerradas. ¿Es spam o no? ¿Va a soporte, ventas o facturación? Del 1 al 5, ¿cómo de urgente es esto? Un modelo de lenguaje genera esa respuesta palabra a palabra, como si escribiera una carta, cuando lo único que querías era que marcara una casilla.
Eso es justo lo que ataca Jev, un modelo lanzado hace poco por TypeSafe AI, empresa fundada en 2024 por Diogo Almeida (unos cuatro años en OpenAI trabajando en RLHF, InstructGPT, ChatGPT y GPT-4), Erik Gafni y Sasha Sheng. Salió el 15 de septiembre de 2026 con 40 millones de dólares de ronda semilla, y en su primera semana ya era el tema de conversación de medio Twitter de IA.
Qué es Jev, en una frase
Un modelo al que le das un texto y una pregunta cerrada, y te devuelve una de las opciones que tú mismo has definido, con su probabilidad. Nada de redacción, nada de explicaciones, nada de "déjame pensarlo". Le preguntas si un email es una queja y contesta: 95% QUEJA. Punto.
TypeSafe lo llama modelo "Sistema Uno", en referencia al libro de Kahneman sobre el pensamiento rápido e intuitivo frente al lento y deliberado. Los LLM tradicionales (ChatGPT, Claude, Gemini) serían el Sistema Dos: razonan, generan, se explican. Jev sería el Sistema Uno: no razona en voz alta, responde de golpe. Piénsalo como un if de toda la vida, pero que entiende lenguaje natural.
El nombre no es casual. Viene de la paradoja de Jevons, esa idea económica de que cuando algo se abarata muchísimo, acabas usándolo en todas partes y para todo. La apuesta de TypeSafe es que hay miles de decisiones pequeñas que hoy no se automatizan porque no compensa (son demasiado triviales para gastar un LLM en ellas) y que, en cuanto el coste cae a casi cero, empiezan a tomarse constantemente.
Por qué es tan rápido y tan barato
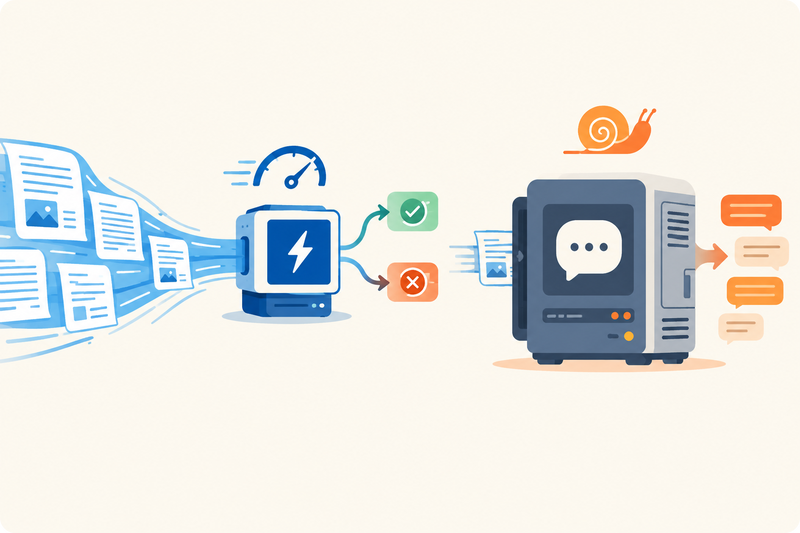
La clave está en que no genera texto. Un LLM normal construye su respuesta token a token, y cada token añade latencia y coste. Jev no hace eso: procesa el texto y la pregunta de una sola pasada y devuelve la opción elegida junto con su probabilidad. No hay generación, así que no hay tokens de salida que pagar. TypeSafe cobra 0,042 dólares por millón de tokens de entrada, y la salida es gratis. El tiempo de respuesta ronda los 70-500 milisegundos.
Para que te hagas una idea de la diferencia real: alguien comparó Jev con Claude Opus 5 analizando páginas web para generar enlaces internos. En 45 segundos, Jev procesó 586 páginas y creó 584 enlaces por 0,21 dólares. Opus, en el mismo tiempo, había procesado 21 páginas y gastado 1,43 dólares; terminar el trabajo entero le costó 43 dólares. Eso es Jev siendo unas 190 veces más barato y 28 veces más rápido en esa tarea concreta.
Los tres tipos de pregunta
Cada llamada a Jev tiene dos partes: el estado (el texto que quieres que juzgue) y una o varias preguntas. Y las preguntas son de tres tipos:
Noul (sí/no): te da la probabilidad de que algo sea cierto. "¿Este mensaje es una queja?" → 95% sí.
Choice (elección): le das una lista de opciones y reparte probabilidad entre ellas. "¿Va a facturación, soporte o ventas?" → facturación 70%, soporte 20%, ventas 10%.
Score (puntuación): le describes una escala y te da un nivel dentro de ella. "Urgencia de 1 a 5" → 4.
Y aquí hay un detalle que cambia bastante el cálculo de coste: puedes meter varias preguntas en la misma llamada, todas evaluadas en paralelo contra el mismo texto. Si le haces 60 preguntas distintas sobre el mismo email, te cuesta prácticamente lo mismo que hacerle una sola. Eso abre la puerta a trocear una decisión compleja en muchas preguntas pequeñas, que es justo la clave de por qué funciona bien en la práctica, como verás luego.
Los números del titular, con su letra pequeña
TypeSafe presentó Jev como "193 veces más rápido y 444 veces más barato". Es un titular llamativo y merece revisarlo con calma, porque la propia empresa reconoce la letra pequeña: en esa prueba, la respuesta "correcta" se define como la media de lo que contestan dos modelos grandes (GPT-6 Astra y Fable 5.1). O sea, ese número mide cuánto se parece Jev a lo que dirían los modelos grandes, no cuánto acierta de verdad. Y la propia empresa admite que es el extremo alto del rango.
Las pruebas independientes de la primera semana son más interesantes que el titular. En detección de phishing sobre 2.000 emails, Jev salió entre 12 y 27 veces más barato que Claude Haiku 4.5. Pero al preguntarle de una sola vez "¿es esto phishing?", Jev acertó el 62,6% de las veces frente al 81,3% de Haiku. Ahí Jev pierde claramente.
La cosa cambia cuando divides la misma decisión en cinco preguntas pequeñas (¿pide credenciales? ¿suplanta una marca conocida? ¿tiene urgencia artificial? y así) y combinas esas respuestas con una fórmula ajustada con 1.000 ejemplos de entrenamiento. Ahí Jev sube al 95,0% de aciertos, superando el 93,2% de Haiku. Empate técnico, con Jev muchísimo más barato. En otra prueba menor, Jev llegó al 98,3%, a la par de un clasificador clásico entrenado con casi 15.000 ejemplos (98,4%).
Jev no resuelve bien las decisiones complicadas. Resuelve muy bien las decisiones simples. Tu trabajo es trocear la pregunta difícil en varias preguntas fáciles.
Importante: son datos de la primera semana, con pruebas pequeñas y sin replicar por terceros de forma independiente. Tómalos como una foto inicial, no como un veredicto cerrado.
Lo que Jev NO es
No escribe nada. Redactar un email, resumir un documento o generar código sigue siendo trabajo de un LLM. Jev no compite con eso, lo complementa.
No da respuestas abiertas. Tú defines las opciones de antemano (hasta 255 como máximo). Si la respuesta correcta no está en tu lista, elige la menos mala de las que le diste. Por eso conviene añadir siempre una opción tipo "ninguna de las anteriores".
"Cero alucinaciones" no significa "siempre acierta". Significa que el formato de salida es siempre válido (nunca te va a devolver algo que no puedas parsear). No significa que la decisión sea correcta. Alguien montó un bot de trading automático con Jev en una tarde y perdió 30.000 dólares confiando en eso.
Solo texto. Nada de imágenes, audio ni vídeo. La demo con el videojuego Doom que circuló estos días no le pasa la pantalla: le pasa el estado interno del juego en forma de texto.
Un clasificador entrenado a medida le puede ganar. Su ventaja no es ser el más preciso del mercado, es que no necesitas datos de entrenamiento ni montar un pipeline de entrenamiento para usarlo.
Contexto limitado. 64.000 tokens por petición en total, con 32.000 disponibles para el texto que le pasas. Para un email o un ticket sobra de largo. Para un contrato de 80 páginas, no llega.
Casos de uso: dónde encaja de verdad
Aquí es donde Jev deja de ser una curiosidad técnica y se convierte en algo que puedes aplicar esta semana. Estos son los usos que más se están viendo desde el lanzamiento:
Triaje de bandeja de entrada
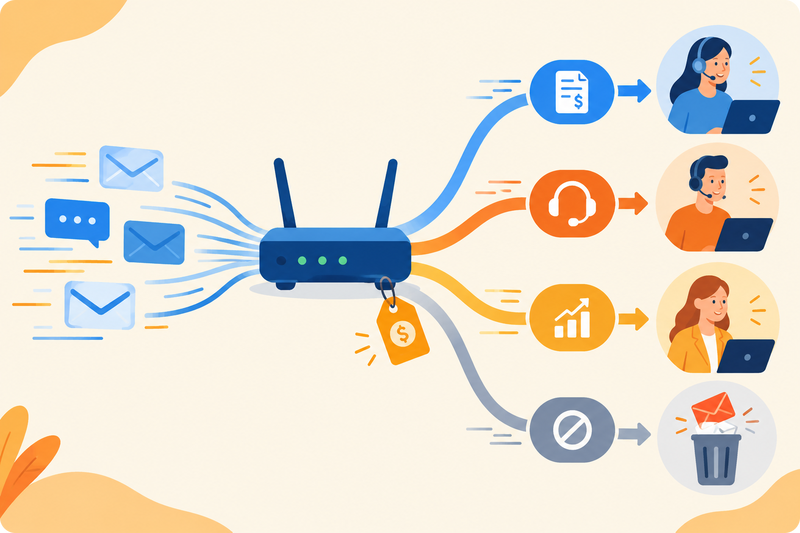
Clasificar cada correo entrante: ¿es de un cliente, un proveedor, spam o una oportunidad de negocio? ¿Es urgente? Con confianza alta, el correo se enruta solo a la carpeta o la persona correcta. Con confianza baja, se manda a una cola de revisión humana.
Cualificación de leads
¿Este contacto encaja con tu cliente ideal? ¿Tiene presupuesto? ¿Está pidiendo precio o solo información general? Preguntas Choice y Noul aplicadas al mensaje de entrada, antes de que nadie del equipo comercial pierda tiempo con él.
Clasificación de contenido a escala
Un desarrollador clasificó 1.018 papers académicos en 24 temas distintos por 8 céntimos de dólar, a 256 milisegundos por documento. Lo caro del proceso, curiosamente, no fue Jev: fue generar los resúmenes previos con otro modelo, que costó 4 dólares. Jev era la parte barata de la ecuación.
Vigilar agentes antes de que actúen
Si tienes un agente de IA que ejecuta comandos o acciones automáticas, Jev puede revisar lo que va a hacer antes de que lo haga. Un ingeniero de Vercel contó que sustituyeron un modelo de OpenAI por Jev para revisar la seguridad de comandos, y obtuvieron respuestas entre 5 y 18 veces más rápidas y, además, más precisas.
Moderación y filtros de comentarios
Clasificar comentarios como positivos, neutros o negativos, o directamente detectar contenido tóxico o spam, a un volumen que con un LLM normal saldría carísimo.
Enrutador de coste entre modelos
Antes de mandar una consulta a un modelo caro, le preguntas a Jev si esa consulta es lo bastante simple como para resolverla con un modelo barato. Jev decide, el modelo grande solo entra en juego cuando hace falta.
Navegación web para agentes
Un agente de navegador equipado con Jev encontró vuelos en Google Flights en 7 segundos por 0,004 dólares. El reparto de tareas que se está consolidando es este: el LLM escribe y razona, Jev decide, y el código ejecuta la acción.
Evaluación de calidad (evals)
Herramientas de observabilidad como Langfuse ya lo usan para evaluar la calidad de las respuestas que dan otros modelos, otra vez aprovechando que es una decisión cerrada y repetitiva a gran volumen.
Cuándo fiarte de la confianza que te da
Cada respuesta de Jev viene con una probabilidad asociada, y esa cifra es la que decide si actúas solo o pides ayuda humana. La documentación oficial pone un ejemplo con banca por voz que sirve como esquema general: con confianza superior a 0,85, el sistema actúa solo. Entre 0,6 y 0,85, pide confirmación antes de actuar. Por debajo de 0,6, pasa el caso a una persona.
Pero ese umbral no viene calibrado de fábrica para tu caso. Tienes que ajustarlo con tus propios datos: coge un conjunto de ejemplos cuya respuesta correcta ya conozcas, mira en qué nivel de confianza empieza a fallar Jev, y fija ahí tu corte. Cuanto más caro te salga equivocarte, más alto debe estar ese umbral.
Dónde no usarlo, bajo ningún concepto
Para escribir o explicar cualquier cosa. Eso es trabajo de un LLM.
Para calcular, contar elementos o comparar fechas. Eso se resuelve con código normal, no con un modelo de lenguaje de ningún tipo.
Con textos enormes o llenos de ruido: pierde precisión cuando hay mucha información irrelevante mezclada con la que importa.
En español sin haberlo probado antes a fondo: de momento funciona mejor en inglés.
Como único filtro de seguridad frente a textos que no controlas. Una instrucción escondida dentro de un email que le pasas puede manipular su respuesta.
En producción crítica todavía. Sigue en acceso anticipado y conviene tratarlo como tal.
Cómo empezar: primero, configura TypeSafe
Jev es una API: no hay una app ni un chat donde escribirle. Pero casi todas las formas de usarlo pasan por lo mismo, tu cuenta de TypeSafe y tu clave. Así que empieza por aquí, y en este orden: probarlo sin código, conectarlo y usarlo.
Paso 1: pruébalo sin programar en el Playground
Entra en la consola de TypeSafe (console.typesafe.ai) y abre el Playground. Es una página donde pegas un texto, escribes tus preguntas y ves al momento qué responde Jev y con qué probabilidad. Todo desde el navegador, sin una línea de código.
Yo empezaría por aquí con cualquier idea que tengas. Pega un email real, pregúntale si es urgente y mira qué te dice. En dos minutos sabes si te sirve para tu caso antes de montar nada.
Paso 2: crea tu clave de API
En la consola de TypeSafe, entra en el apartado Keys y crea una clave nueva.
Cópiala y trátala como una contraseña: nada de pegarla en un chat, un documento compartido o un repositorio público.
Guárdala en tu ordenador como variable de entorno con el nombre `TYPESAFE_API_KEY`. De ahí la leen tanto el SDK oficial como el skill de Claude Code.
Si nunca has creado una variable de entorno, pídele a Claude Code o a ChatGPT que te explique cómo hacerlo en tu sistema (Mac o Windows). Eso sí, la clave la pegas tú en tu terminal, no en la conversación.
Paso 3: elige cómo usarlo
Con la clave lista, tienes varias vías según cómo trabajes.
Si usas Claude Code o Codex
Es el camino más sencillo si ya trabajas con alguno de estos entornos. TypeSafe tiene un skill oficial publicado en github.com/typesafe-ai/skills. En Claude Code se instala así:
/plugin marketplace add typesafe-ai/skills
/plugin install typesafe@typesafe-ai
Con el skill instalado y tu clave configurada, ya puedes describirle la tarea en lenguaje natural:
Tengo estos emails/tickets/leads en un CSV. Quiero clasificarlos en estas categorías usando la API de Jev, y que los de confianza baja se guarden aparte para revisarlos yo.
Si programas en Python: el SDK oficial
El SDK de TypeSafe se instala con un comando (pide Python 3.10 o superior) y con unas pocas líneas ya tienes tu primera decisión. Este ejemplo le pregunta si un mensaje expresa urgencia:
pip install typesafe-sdk
from typesafe_sdk import Noul, TypeSafeClient
client = TypeSafeClient()
response = client.system_one(
state="Necesito la factura hoy antes de las 5 o no puedo cerrar el mes",
questions={"urgencia": Noul(instructions="¿Este mensaje expresa urgencia?")},
)
print(response.answers["urgencia"].noul)
También hay SDK para TypeScript, y si prefieres Pydantic AI, lo tienes integrado: se instala con `pip install "pydantic-ai-slim[typesafe]"` y usas el modelo `typesafe:jev-latest`.
Sin cuenta en TypeSafe: OpenRouter y Cloudflare
Si ya usas OpenRouter, Jev está ahí con el modelo `typesafe/jev-1.13` (o `~typesafe/jev-latest`), llamando al endpoint `https://openrouter.ai/api/alpha/decisions` con un "state" (el texto) y tus "questions". Cada respuesta te dice lo que ha costado en dólares. Y el SDK oficial de TypeSafe también funciona apuntándolo a OpenRouter, sin crear cuenta con ellos.
En Cloudflare Workers AI está como `typesafe/jev`, al mismo precio (0,042 dólares por millón de tokens de entrada, salida gratis y entrada en caché gratis) y con cero retención de datos.
El paso que no te puedes saltar
Elijas la vía que elijas, hay un paso obligatorio: prueba con 50 casos cuya respuesta ya conozcas de antemano. Mira dónde falla, ajusta la redacción de tus categorías y fija tu umbral de confianza con esos datos reales. Ese único paso es la diferencia entre el desarrollador que clasificó 1.018 papers por 8 céntimos y el que perdió 30.000 dólares confiando ciegamente en un bot de trading.
Lo que te llevas
Jev no escribe: responde preguntas cerradas (sí/no, elección o puntuación) sobre un texto, en menos de medio segundo y con la salida gratis.
Su punto fuerte son las decisiones simples troceadas en varias preguntas pequeñas, no una única pregunta compleja.
La confianza que te da no viene calibrada para tu caso: tienes que ajustar el umbral con tus propios datos antes de dejarlo actuar solo.
Empieza por el Playground de TypeSafe, sin código. Después crea tu clave (TYPESAFE_API_KEY) y úsalo desde Claude Code, el SDK de Python, Pydantic AI, OpenRouter o Cloudflare.
Comentarios
Aún no hay comentarios. ¡Sé el primero en comentar!